点推定とは何か
未知の量を一つの値として推定する方法を「点推定」と呼びます。例えば、最小二乗法で得られるモデルパラメータや、画像中の信号の重心位置は点推定です。点推定は複雑なデータを簡潔に要約できる一方、推定値だけでは、データ量やノイズによって結果がどの程度変動し得るかまでは分かりません。
主な点推定法
手法 | 得られる推定値 |
|---|---|
標本平均・中央値 | データの中心を表す値 |
最小二乗法 | 誤差の二乗和を最小にするパラメータ |
最尤推定 | 観測データが最も生じやすくなるパラメータ |
重心法 | 信号強度で重み付けした位置座標 |
MAP推定 | 事後確率密度が最大となるパラメータ |
表に示すように、点推定には目的に応じたさまざまな方法があります。標本平均や中央値はデータの中心を、最小二乗法や最尤推定はモデルのパラメータを、重心法は画像中の信号位置を一つの値として表します。ベイズ推論で用いられるMAP推定も、事後分布から一つの代表値を選ぶ点推定の一種です。
点推定値と不確実性
同じ推定値が得られたとしても、その値に残る不確実性が同じとは限りません。データ数が多くノイズが小さい場合と、わずかなデータから大きなノイズを含む信号を解析した場合では、推定値の周囲に残る不確実性が異なるためです。分布の中心が同じでも、分布が狭ければ候補となる値は中心付近に集中し、分布が広ければより広い範囲の値が残ります。この違いを図1に示します。
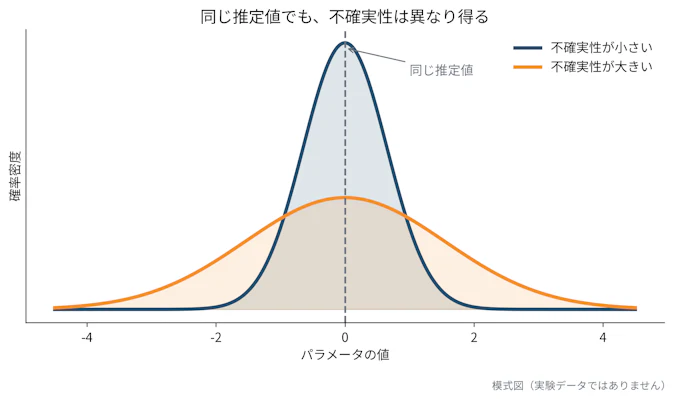
図1. 推定値と分布の広がり
図1では、二つの分布の中心は同じですが、分布の幅が異なります。不確実性を示す考え方はベイズ推論に限られず、頻度論的な統計解析でも標準誤差や信頼区間を用いて推定のばらつきを評価できます。重要なのは、代表値だけを見るのではなく、その値がどの程度変動し得るかを併せて確認することです。
ベイズ推論ではパラメータの不確実性を分布で表す
ベイズ推論の特徴は、未知のパラメータを一つの固定値として扱うのではなく、その候補を確率分布として表す点にあります。観測前の知識と観測データを組み合わせて分布を更新することで、代表的な推定値だけでなく、どの範囲の値がデータと整合的なのかを同時に捉えます。
ベイズの定理:事前分布から事後分布へ
推定したいパラメータをθ、観測データをDとすると、ベイズの定理は次のように表されます。
$$ p(\theta \mid D) = \frac{p(D \mid \theta)\,p(\theta)}{p(D)} \propto p(D \mid \theta)\,p(\theta) $$
ここで、p(θ)は観測前にパラメータについて想定する事前分布、p(D | θ)は各パラメータのもとで観測データがどの程度生じやすいかを表す尤度、p(θ | D)はデータを観測した後の事後分布です。p(D)は周辺尤度と呼ばれ、事後分布全体を確率分布として正規化するための項です。したがって、事後分布は「事前分布×尤度」に比例すると考えられます。この関係を図2に示します。
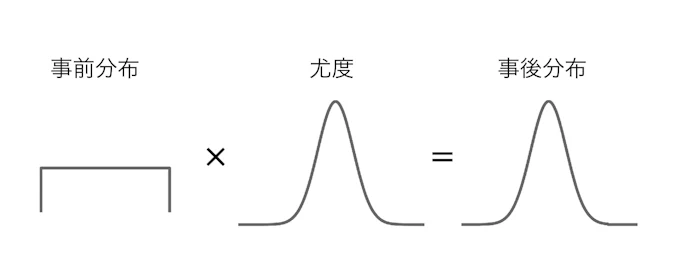
図2. 事前分布・尤度・事後分布の関係
図2では、指定した範囲内の値を同程度に想定する一様事前分布を例にしています。事前分布の形や範囲は、既知の情報、物理的な制約、解析の目的に応じて設定されます。これを観測データから得られる尤度と組み合わせて正規化することで、事後分布が得られます。
MAP推定と事後分布の広がり
事後分布からは、事後確率密度が高い値だけでなく、パラメータの候補がどの範囲に集中しているかを読み取れます。事後分布が狭ければ、仮定したモデルと事前分布のもとで候補は比較的限定されています。一方、事後分布が広ければ、データだけでは候補を十分に絞り込めず、複数の可能性が残っていると解釈できます。
事後分布から一つの代表値を示す方法として、事後分布の確率密度が最大となるパラメータを選ぶMAP(maximum a posteriori)推定があります。MAP推定値は次式で表されます。
$$ \hat{\theta}_{\mathrm{MAP}} = \arg\max_{\theta} p(\theta \mid D) $$
ここで、$$ \hat{\theta}_{\mathrm{MAP}} $$は事後分布 $$ p(\theta \mid D) $$が最大となるパラメータです。MAP推定値は分布のもっとも高い位置を簡潔に示せますが、それだけでは事後分布の広がりは分かりません。したがって、同じMAP推定値が得られても、分布の幅が異なれば、推定に残る不確実性も異なります。
本記事で扱う不確実性は、結果の正しさや信頼性全般を保証するものではありません。与えたデータ、モデル、事前分布のもとで、事後分布が表すパラメータの不確実性を指します。モデルや事前分布の設定が変われば事後分布も変わり得るため、解析条件を明示することが重要です。
ベイズ信用区間と頻度論的信頼区間
推定の不確実性を区間として表す方法には、ベイズ推論における「信用区間」と、頻度論で用いられる「信頼区間」があります。名称は似ていますが、両者では確率の意味が異なります。
ベイズ信用区間は、事後分布の一定の確率を含む範囲です。たとえば95%信用区間は、与えたデータ、モデル、事前分布のもとで、パラメータがその区間に含まれる事後確率が95%となる範囲です。
一方、頻度論の95%信頼区間は、同じ測定と区間推定を繰り返したときに、得られる区間の95%が固定された真の値を含むように構成された区間です。頻度論では真のパラメータは固定されており、測定ごとに変化するのはデータから計算される区間です。両者における「95%」の意味の違いを図3に示します。
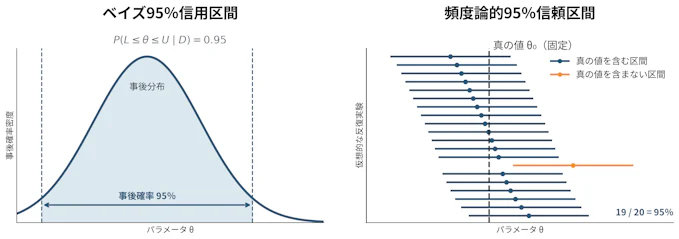
図3. ベイズ信用区間と頻度論的信頼区間
図3の左側では、一回の観測から得られた事後分布のうち、95%の事後確率を含む範囲を示しています。右側では、真のパラメータを固定し、測定と区間推定を繰り返したときに、得られる区間の95%が真の値を含む様子を示しています。
このように、同じ「95%」でも、ベイズ信用区間と頻度論的信頼区間では確率の意味が異なります。本記事では、未知のパラメータを事後分布として捉えるベイズ推論の考え方に注目します。
低カウントの計数型画像への応用
粒子や光子などの離散的な検出イベントを画素ごとに数える画像を、計数型画像と呼びます。たとえば二次イオン質量分析(SIMS: Secondary Ion Mass Spectrometry)では、試料表面から放出され、検出器で検出された二次イオンの数が各画素に記録されます。光子計数型の測定や、一部の電子計数型の測定も計数型画像の例です。各画素で得られるカウント数が少ない計数型画像では、統計的な揺らぎの影響が相対的に大きくなります。以下では、このような画像を「低カウント画像」と呼びます。
図4は、SIMSのイオン計数画像を模して作成した仮想的な低カウント画像です。各画素の色は、その画素で検出されたカウント数を表しています。

図4. SIMSのイオン計数画像を模した低カウント画像
計数型画像では、一定の条件のもとで、各画素のカウントをポアソン分布によって表すことがあります。ポアソン分布では、期待カウント数が小さいほど、平均に対する観測値の揺らぎが相対的に大きくなります。そのため、低カウント画像では、同じ信号を測定しても画素ごとのカウント配置が変動しやすくなります。
ただし、すべての画像にポアソン分布をそのまま適用できるわけではありません。読み出しノイズや背景信号などの影響が大きい場合には、それらを含めた測定モデルが必要です。本節では、画素値を離散的な検出イベントの数として扱える計数型画像を対象とします。
ROIを用いた重心推定
画像中で解析対象として選択した領域を、ROI(Region of Interest)と呼びます。計数型画像から信号の中心位置を求める簡便な方法の一つに、重心法があります。重心法は、ROI内の各画素のカウントを重みとして、信号位置の代表座標を求める点推定法です。
画素$$ {(i,j)} $$の座標を$$ {(ui,vj)} $$、その画素で観測されたカウントを$$ {y_{ij}} $$ とすると、重心による信号位置の推定値$$ {(\hat{\mu}_G =, \hat{\nu}_G)} $$は、
$$ \hat{\mu}_G = \frac{ \sum_{(i,j)\in\mathrm{ROI}} u_i y_{ij} }{ \sum_{(i,j)\in\mathrm{ROI}} y_{ij} }, \qquad \hat{\nu}_G = \frac{ \sum_{(i,j)\in\mathrm{ROI}} v_j y_{ij} }{ \sum_{(i,j)\in\mathrm{ROI}} y_{ij} } $$
と表されます。
重心法は直感的で計算も容易ですが、どの画素を計算に含めるかによって結果が変化します。特にカウント数が少ない場合には、ROI内に偶然含まれた少数のカウントが重心に大きく影響し、ROIを移動すると推定座標が変わることがあります。図5は、同じ仮想画像に二つのROIを設定し、それぞれの範囲で重心を計算した例です。
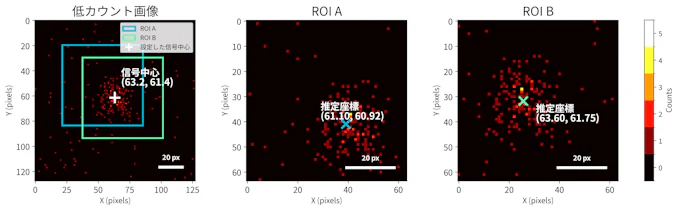
図5. 低カウント画像において、ROIの違いにより重心推定座標が変化する例
この例は、どちらのROIが正しいかを判断するためのものではありません。重心法によって一つの推定座標を得ることはできますが、その座標が観測された少数のカウントに対してどの程度安定しているかは、重心座標だけからは判断できません。
位置を事後分布として推定する
そこで、信号位置を一つの座標だけでなく、ベイズ推論によって事後分布として推定する方法を考えます。信号中心 $$ {(μ,ν)}$$ 、信号強度、信号の広がりなどを含むモデルパラメータを とします。θを与えたとき、画素 $$ {(i,j)}$$における期待カウント数を $$ {S(i,j\mid\Theta)} $$と表します。
$$ {S(i,j\mid\Theta)} $$の具体的な形は、測定方法や対象とする信号に応じて設定します。例えば、点状の信号が測定系の応答によってガウス状に広がって観測される場合には、二次元ガウス関数に背景カウントを加えたモデルで $${S(i,j\mid\Theta)}$$を表すことができます。
画素$$ {(i,j)} $$で観測されるカウント $$ y_{ij} $$を、期待値$$ {S(i,j\mid\Theta)} $$のポアソン分布に従うと仮定します。すなわち、
$$ y_{ij} \sim \operatorname{Poisson}\left(S(i,j\mid\Theta)\right) $$
と表します。このとき、画素$$ {(i,j)} $$でカウント$$y_{ij} $$が観測される確率は、ポアソン分布の確率質量関数から、
$$ p(y_{ij}\mid\Theta) = \frac{ S(i,j\mid\Theta)^{y_{ij}} \exp\left[-S(i,j\mid\Theta)\right] }{ y_{ij}! } $$
となります。
さらに、パラメータ を与えたとき、各画素の観測が互いに独立であると仮定します。解析対象となる画像、またはROI内の観測カウント全体を、
$$ Y = \left\{ y_{ij} \right\}_{(i,j)\in\mathrm{ROI}} $$
とすると、画像全体の尤度は各画素における確率の積として、
$$ p(Y\mid\Theta) = \prod_{(i,j)\in\mathrm{ROI}} \frac{ S(i,j\mid\Theta)^{y_{ij}} \exp\left[-S(i,j\mid\Theta)\right] }{ y_{ij}! } $$
と表されます。この尤度は、ある信号位置や信号形状を仮定したときに、実際に観測されたカウント配置がどの程度生じやすいかを表します。
尤度に事前分布 $$ p(\Theta) $$ を組み合わせると、ベイズの定理から事後分布は、
$$ p(\Theta\mid Y) = \frac{ p(Y\mid\Theta)\,p(\Theta) }{ p(Y) } \propto p(Y\mid\Theta)\,p(\Theta) $$
と求められます。位置について事前情報が乏しい場合には、一例として、解析範囲内の各位置を同程度に想定する一様事前分布を設定できます。
以下では、信号強度、信号形状、および背景カウントに関するパラメータに関するパラメータを固定し、仮想データから位置パラメータ $$ {(μ,ν)} $$ のみを推定しました。図6では、色が相対事後確率密度、+が設定した信号中心、×がMAP推定位置を表します。実線と破線は、それぞれ50%および95%信用領域です。
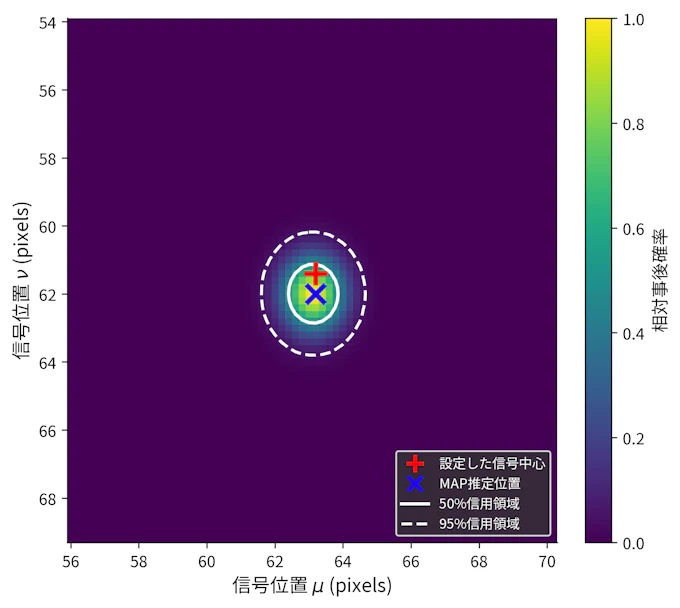
図6. 位置パラメータμ, νの二次元事後分布
二次元事後分布から、もう一方の位置パラメータについて積分して周辺化することで、 と それぞれの周辺事後分布が得られます。図7の点線は設定値、破線は二次元MAP推定位置の各座標成分、着色部分は95%信用区間を示します。
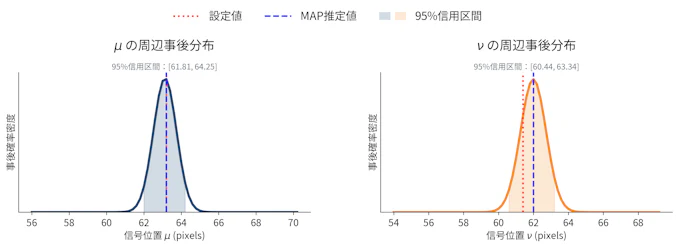
図7. 位置パラメータ μ, νの周辺事後分布
重心法が信号位置を一つの座標として示すのに対し、ベイズ推論では、推定位置とその不確実性を同じ事後分布から評価できます。その広がりを見ることで、現在のデータで信号位置をどの程度絞り込めているかを確認し、追加測定や解析条件の見直しが必要かを判断できます。ただし、得られる事後分布は、設定した信号モデル、ROI、事前分布などの仮定に基づきます。
まとめ
点推定は、複雑なデータを一つの分かりやすい値にまとめる有用な方法です。しかし、同じ推定値であっても、データ量やノイズ、解析条件によって周囲に残る不確実性は異なります。代表値だけでは、データからどの程度までパラメータを絞り込めたのかを判断できません。
ベイズ推論では、事前分布と尤度を組み合わせて事後分布を求めることで、推定値と不確実性を同じ枠組みで表現できます。特に低カウントの計数型画像のように統計的な揺らぎが相対的に大きいデータでは、一つの座標だけでなく、候補となる位置の分布を見ることが重要です。「最もよい推定値は何か」に加えて、「その周囲にどの程度の可能性が残っているか」を確認することが、結果を過度に断定せず、測定や解析の条件を適切に判断するための手がかりになります。
参考文献
- G. Casella and R. L. Berger, “Statistical Inference”, 2nd ed., Duxbury (2002).
- D. C. Montgomery, E. A. Peck, and G. G. Vining, “Introduction to Linear Regression Analysis”, 5th ed., Wiley (2012).
- R. C. Gonzalez and R. E. Woods, “Digital Image Processing”, 4th ed., Pearson (2018).
- P. D. Hoff, “A First Course in Bayesian Statistical Methods”, Springer (2009).
- K. Nagata, R. Muraoka, Y.-I. Mototake, T. Sasaki, and M. Okada, “Bayesian Spectral Deconvolution Based on Poisson Distribution: Bayesian Measurement and Virtual Measurement Analytics (VMA)”, J. Phys. Soc. Jpn. 88, 044003 (2019).
- L. Hespanhol, C. S. Vallio, L. M. Costa, and B. T. Saragiotto, “Understanding and interpreting confidence and credible intervals around effect estimates”, Braz. J. Phys. Ther. 23, 290–301 (2019).
- R. D. Morey, R. Hoekstra, J. N. Rouder, M. D. Lee, and E.-J. Wagenmakers, “The fallacy of placing confidence in confidence intervals”, Psychon. Bull. Rev. 23, 103–123 (2016).
- N. P. Lockyer et al., “Secondary ion mass spectrometry”, Nat. Rev. Methods Primers 4, 32 (2024).
- M. Wang et al., “Bayesian Localization and Uncertainty Quantification of Trace Species in Two-Dimensional SIMS Imaging”, arXiv:2608.08495 (2026).